RAGとは?意味・仕組みと資料をもとに答えるツール(2026年10月時点)
RAG
検索拡張生成 / Retrieval-Augmented Generation / リトリーバル拡張生成
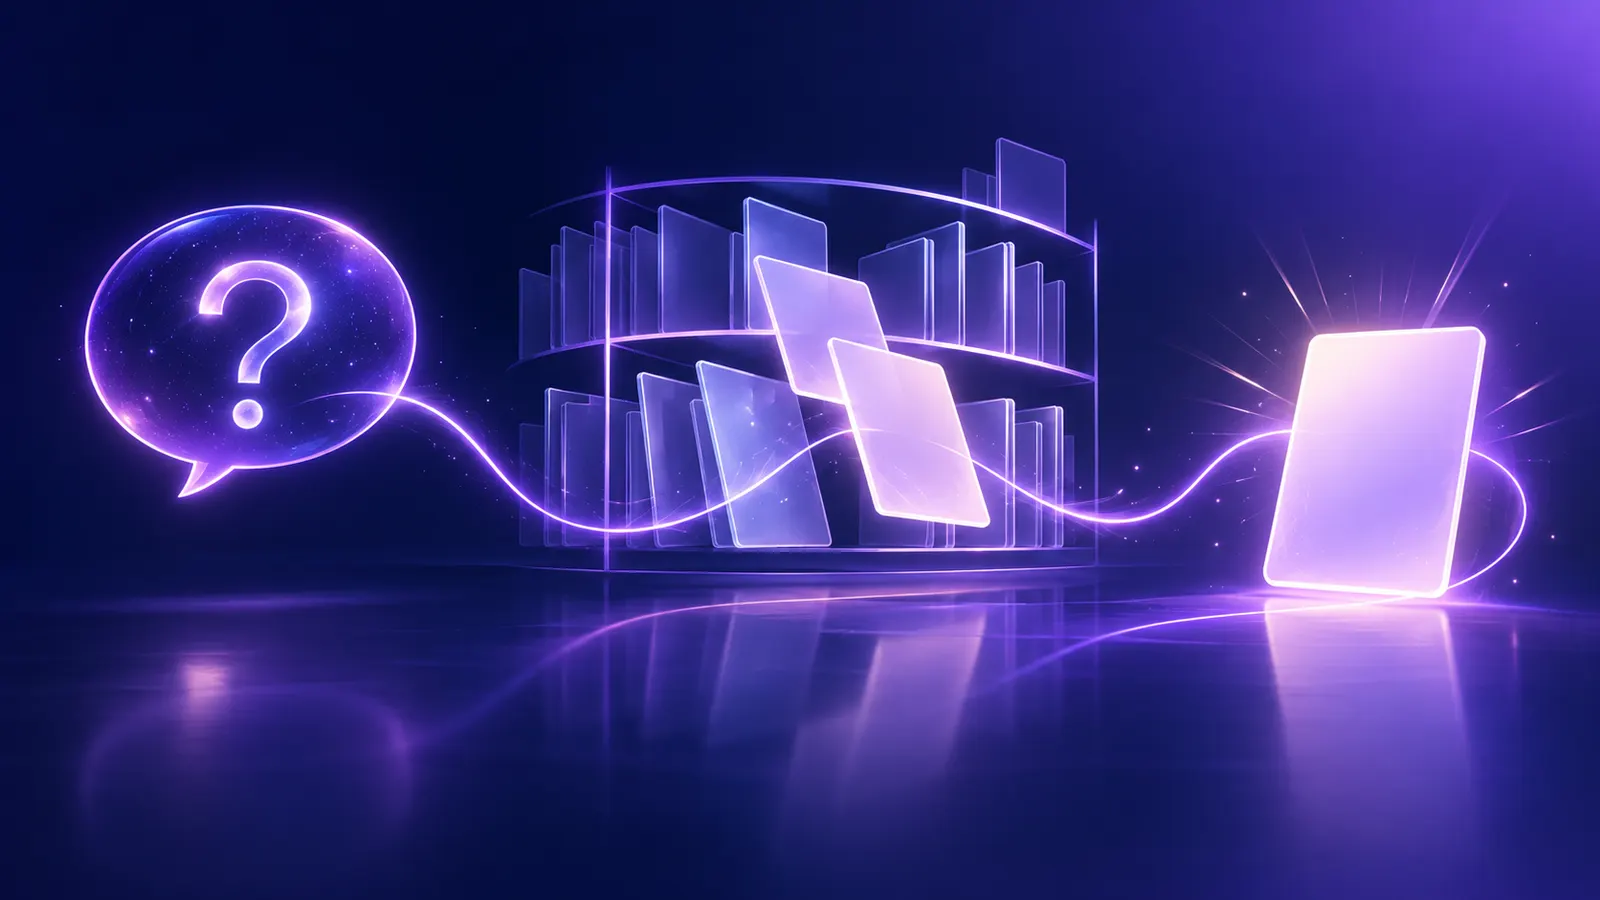
RAG(検索拡張生成)とは、AIが答える前に社内の文書などの資料から関係する部分を検索し、その内容をプロンプトに足して答えをつくる仕組みのこと。
要するに
- 資料を小さく分けて数値に変え、質問と意味の近い部分を探して渡す
- モデルを学習し直さずに、新しい資料や社内の情報を答えに使える
- 検索で関係する部分を取り出せないと、AI は正しく答えられない
最終確認
資料をもとに答える機能を持つツール




原論文と関連研究
- RAGの原論文を読む 検索と文章生成をどう結びつけたかRetrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
- REALM 論文の解説:検索器を言語モデルの事前学習に組み込むREALM: Retrieval-Augmented Language Model Pre-Training
- DPRの原論文を読む 質問に合う文章をどう探すかDense Passage Retrieval for Open-Domain Question Answering
- RETROの原論文を読む 大量の外部文書を引いて書くImproving language models by retrieving from trillions of tokens
- Self-RAGの原論文を読む 検索するかもモデルが決めるSelf-rag: Learning to Retrieve, Generate, and Critique through Self-Reflection
- GraphRAG 論文の解説:資料全体の傾向を問う質問にRAGで答えるFrom Local to Global: A Graph RAG Approach to Query-Focused Summarization
目次8
ひとことで言うと
RAG(Retrieval-Augmented Generation、検索拡張生成)は、AI が答える前に、社内の文書のような資料から質問に関係する部分を検索し、その内容をプロンプトに足してから答えをつくる仕組みだ。AI のモデルが学習していない情報や新しい情報でも、資料に書いてあれば答えに使える。
たとえば顧客対応のチャットボットは、その会社についての知識が要る。Anthropic はこうした例を挙げ、AI の知識を補う方法として開発者がふつう使うのが RAG だと説明している。
仕組み
Anthropic の解説に沿うと、RAG は準備と回答の2つの段階で動く。
- 準備:資料をチャンク(数百トークンほどの小さなかたまり)に分ける。トークンは AI が文章を数える単位だ。
- 準備:埋め込みモデルで、各チャンクを意味を表す数値(ベクトル)に変える。
- 準備:その数値をベクトルデータベースに保存する。意味の近さで検索できるデータベースだ。
- 回答:質問が来ると、質問も数値に変え、意味の近いチャンクを探す。
- 回答:見つかったチャンクをプロンプトに足し、AI が答えをつくる。
Google の Gemini API のファイル検索も、ファイルを自動でチャンクに分け、埋め込み、索引をつくる。Google はこれを、キーワードの一致でなく質問の意味をとらえる検索だと説明している。一方 Anthropic は、意味の検索は「エラーコード TS-999」のような正確な語の一致を取りこぼすことがあり、語の一致で探す方法と組み合わせると精度が上がるとしている。
RAG は、2020年5月に Patrick Lewis らが発表した論文(TRAIL の解説)で提案された。論文はモデルの中に覚えた知識と、Wikipedia を検索できる外の記憶を組み合わせ、より具体的で事実に沿った文章をつくれたと報告している。
表で見る最新の状況
上の表は取り込んだ資料や社内の情報をもとに答える機能を持つ6つのツールの無料プランの有無、いちばん安い有料プラン、日本語の画面の有無を並べたものだ。料金の確認日は2026年10月10日から10月23日。6つとも無料プランが「あり」で、日本語の画面がある。
- Dify は TRAIL の DB でナレッジ(RAG)の機能を持つと書かれている開発基盤だ。いちばん安い有料プランの Professional は1ワークスペースあたり月$59で、ナレッジに入れられる文書は500件までだ。
- NotebookLM は取り込んだ資料だけを根拠に答える Google のツールだ。Google AI Plus は月¥725で、ノートブック200件、ソース100件まで使える。
- Claude の Pro は月$20だ。Anthropic のヘルプによると、Projects の資料がコンテキストウィンドウの上限に近づくと自動で RAG に切り替わる機能は、Pro 以上の有料プランで使える。
- Notion AI の Plus は1人あたり月¥1,650だが、AI の機能は試用だけだ。
TRAIL の年表では、資料をもとに答える機能は2023年11月14日の Notion の「Q&A by Notion AI をベータ公開」、2024年6月25日の Claude の「Projects を追加」と続いた。2025年には Dify が9月22日に「v1.9.0 で Knowledge Pipeline を追加」し、Manus も12月1日に指示とナレッジを保存できる Projects を全プランに加えた。
TRAIL の比較表では、6つのツールのいちばん安い有料プランの中身が、文書の件数の上限から AI の試用だけまで分かれている。
RAG とファインチューニング、長いプロンプトの違い
| RAG | ファインチューニング(モデルの中に覚えさせる) | 資料を全部プロンプトに入れる | |
|---|---|---|---|
| 知識を置く場所 | モデルの外の検索先(ベクトルデータベースなど) | モデルの中のパラメーター | 毎回のプロンプト |
| 新しい知識への対応 | 検索先の文書を足すか入れ替える | 原論文は、モデルの中の知識を更新するのは未解決の課題だとしている | 毎回の入力に入れる |
| 答えの根拠 | 取り出した文書を引用として示せる | 原論文は、根拠を示すことも未解決の課題だとしている | 入れた資料の中にある |
| 向いている量 | コンテキストウィンドウに入りきらない量 | (出典に記載なし) | Anthropic は20万トークン(約500ページ)より小さければこれでよいとしている |
ファインチューニングはモデル自体を追加学習で変える方法で、RAG はモデルを変えずに渡す情報を変える方法だ。資料が少ないうちは、RAG を組まずに全部をプロンプトに入れる方法も選べる。
仕事でどう関係するか
社内の規程やマニュアルに答える AI を作りたいとき
規程やマニュアルがコンテキストウィンドウに入りきらない量なら、RAG が向く。API で作るなら、OpenAI のファイル検索のように提供元がサーバー側で検索まで行う道具もあり、検索のコードを自分で書かずに済む。画面の操作で作るなら、Dify のナレッジの機能を使う方法がある。
答えの根拠を確かめたいとき
Google のファイル検索は、答えをつくるのにアップロードした文書のどの部分を使ったかを、引用として付けることがあり、PDF ならページ番号も付くことがある。Google はこれが事実の確認に役立つとしている。社内で使うなら、根拠の文書を示すよう AI に頼んでおくとよい。
アップロードした就業規則だけをもとに、育児休業を取れる期間と申請の締め切りを答えてください。
答えには、根拠にした条文の番号と文書の名前を付けてください。
就業規則に書かれていない場合は「規則に記載がない」と答えてください。
費用を見積もるとき
Google のファイル検索では、文書を登録するときの埋め込みに料金がかかり、保存と、検索のときの埋め込みは無料だ。取り出した文書は、ふつうの入力のトークンとして料金がかかる。OpenAI は取り出す件数を減らすとトークンと待ち時間を減らせる一方、答えの質が下がることがあると書いている。
注意点と限界
- 検索で関係する部分を取り出せないと、AI は正しく答えられない。Anthropic は、資料を小さく分けたチャンクが文脈を失い、検索が失敗することが多いと書いている。たとえば「売上は前の四半期より3%伸びた」という一文だけでは、どの会社のいつの話かわからない。
- Anthropic はチャンクごとに文書の中での位置づけを短く書き足す方法で、検索の失敗を49%減らせたと報告している。並べ替えの処理と組み合わせると67%減ったという。
- 資料のファイル名や置き方も検索の結果に関わる。Anthropic のヘルプはファイルにわかりやすい名前を付け、関係する文書を同じプロジェクトにまとめるよう勧めている。
- Google のファイル検索は、1つの文書の大きさが100MBまでで、音声と動画のファイルには対応していない。
よくある質問
RAG は何の略か
Retrieval-Augmented Generation の略で、日本語では検索拡張生成と呼ぶ。AI が答える前に資料を検索し、その内容を足して答えをつくる仕組みを指す。
LLM と RAG の違いは何か
LLM は文章を読み書きする AI のモデルで、RAG はその LLM に検索した資料を渡して答えさせる仕組みだ。原論文は学習で覚えた知識と、外から検索する知識を組み合わせる方法として RAG を提案した。
ChatGPT と RAG の違いは何か
ChatGPT は AI のサービスで、RAG は仕組みの名前だ。TRAIL の年表では、ChatGPT は2025年10月23日に、接続した社内ツールの情報を参照して答える company knowledge を Business、Enterprise、Edu に加えた。
RAG の欠点は何か
検索がうまくいかないと、関係のない部分を渡したり、必要な部分を取りこぼしたりする。Anthropic は、資料を細かく分けると文脈が失われ、検索に失敗しやすいと書いている。
コンテキストウィンドウが長ければ RAG は要らないか
資料が少なければ要らないことがある。Anthropic は20万トークン(約500ページ)より小さい資料なら、全部をプロンプトに入れればよいとしている。それより多い資料には RAG がふつうの方法だという。
関連する用語
- コンテキストウィンドウ:RAG で取り出した情報も、この範囲に入れて渡す
- ファインチューニング:モデル自体を追加学習で変える、RAG と比べられる方法
- LLM(大規模言語モデル):RAG で資料を渡す先のモデル
- ハルシネーション:AI が事実と違うことを答える現象
- ディープリサーチ:ウェブを何度も検索して報告書にまとめる機能
- ツール:Dify、NotebookLM、Claude、ChatGPT、Notion AI
出典
- 公開
- 執筆
- TRAIL編集部(編集方針)