拡散モデルとは?意味・仕組みと原論文、使っているツール(2026年10月時点)
拡散モデル(かくさんもでる)
Diffusion Model / 拡散確率モデル
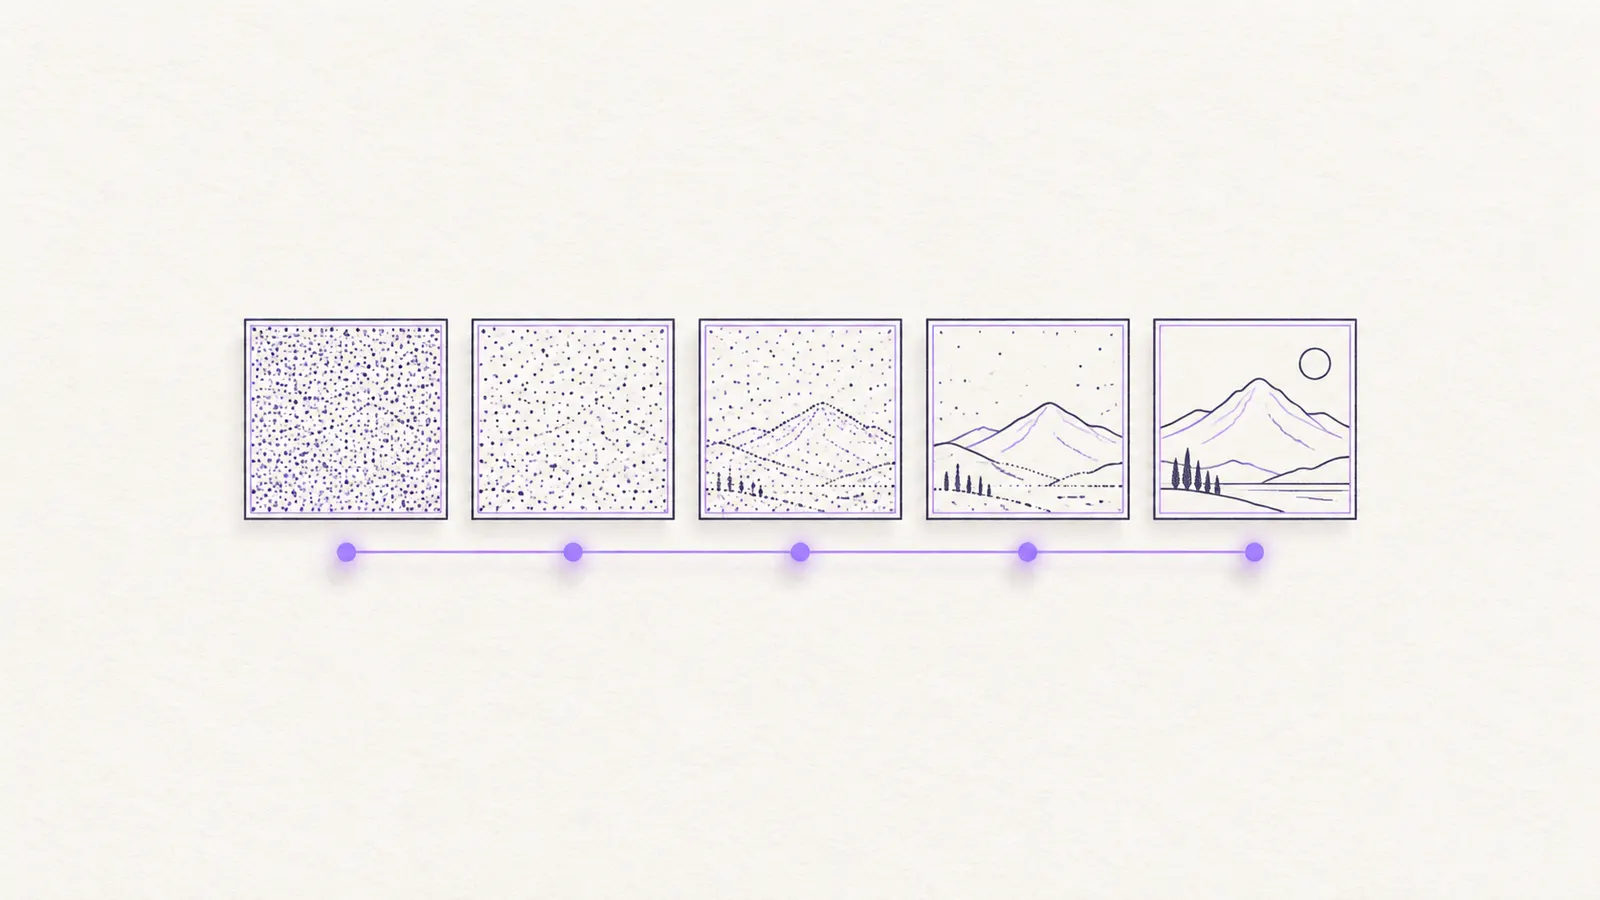
拡散モデルとは、データにノイズを少しずつ足す過程の逆向きに、ノイズを取り除くことを学んだAIモデルのこと。でたらめなノイズから出発し、段階を重ねて画像や動画を作る。
要するに
- ノイズを足す過程を逆にたどることを学び、ノイズから新しい画像を作る
- Firefly、FLUX、Kling、Seedance には拡散モデルと公式に記す版がある
- 段階を順に計算するため、生成は GAN より遅いと原論文が指摘している
最終確認
原論文と関連研究
- DDPMの原論文を読む ノイズを戻して画像を作るDenoising Diffusion Probabilistic Models
- Latent Diffusionの原論文を読む 画像生成を潜在空間へHigh-Resolution Image Synthesis with Latent Diffusion Models
- Imagen 論文の解説:言語モデルの理解力を画像生成に使うPhotorealistic Text-to-Image Diffusion Models with Deep Language Understanding
- DreamBooth 論文の解説:少数の写真から特定の被写体を覚えさせるDreamBooth: Fine Tuning Text-to-Image Diffusion Models for Subject-Driven Generation
- DiT 論文の解説:画像拡散モデルの中心をTransformerに替えるScalable Diffusion Models with Transformers
拡散モデルを使うと公式に説明したモデルがあるツール

目次8
ひとことで言うと
拡散モデル(Diffusion Model)は、データにノイズを少しずつ足して壊していく過程を考え、その逆向きにノイズを取り除くことを学んだ AI のモデルだ。学習を終えたモデルはでたらめなノイズから出発して、ノイズを段階的に取り除きながら新しい画像や動画を作る。
たとえば拡散モデルを使う画像生成のツールに「夕焼けの海辺に立つ灯台」と打ち込むと、裏ではノイズだけの画像から始めて、文章に合う絵へ段階を重ねて近づける処理が動く。できあがるのは、学習したデータらしい新しい画像だ。
仕組み
DDPM の原論文(2020年6月19日、Jonathan Ho ほか)と、Latent Diffusion の原論文(2021年12月20日、Robin Rombach ほか)に書かれている流れをまとめると、次のようになる。
- ノイズを足していく:学習用の画像に、ガウスノイズ(正規分布に従うでたらめな値)を少しずつ足し、元の画像の情報がなくなるまで壊す。論文はこれを「拡散過程(diffusion process)」と呼ぶ。DDPM の実験では段階の数を1,000にしている。
- 取り除くことを学ぶ:ノイズが混じった画像と「何段階目か」を受け取り、足されたノイズを予測するように、ニューラルネットワーク(データから規則を学ぶ計算の仕組み)を学習させる。DDPM は U-Net という構造を使った。
- ノイズから作る:生成するときは、ノイズだけの状態から始め、予測したノイズを取り除く操作を段階の数だけ繰り返す。DDPM の論文によると、途中では大まかな形が先に現れ、細部は最後に現れる。
- 文章で指示する:Latent Diffusion は、クロスアテンション(文章などの条件を画像の生成に反映させる層)を加え、文章や配置の枠を条件にして画像を作れるようにした。Imagen の論文(2022年5月23日)は、文章だけで学習した大規模な言語モデル T5 を文章の読み取りに使っている。
- 縮めた空間で動かす:Latent Diffusion は画像をオートエンコーダ(データを小さく縮めて戻す仕組み)で圧縮した「潜在空間」で拡散を行い、画素のまま扱う場合より計算を大きく減らした。
考え方そのものは、Jascha Sohl-Dickstein らが2015年3月12日に出した論文が先にある。非平衡統計物理学から着想を得て、データの構造を拡散過程でゆっくり壊し、構造を戻す逆向きの過程を学ぶという方法だ。DDPM は2020年にこの種類のモデルで高品質な画像を作れることを示した。無条件の CIFAR10 では FID(生成した画像の品質を測る指標)で当時の最高の3.17を報告している。
表で見る最新の状況
上の1つめの表は、TRAIL が解説した拡散モデルの論文を並べたものだ。2020年の DDPM が画像生成の品質を示し、2021年の Latent Diffusion が計算を減らし、2022年に文章から画像を作る Imagen と、少ない写真で特定の被写体を覚えさせる DreamBooth が続いた。2022年12月19日の DiT は、U-Net を Transformer(文章の AI でも使われる構造)に置き換え、計算量を増やすほど FID が下がることを示した。DiT は、クラスを指定して作る ImageNet 256×256 の生成で FID 2.27 を報告している。
2つめの表は、拡散モデルを使うと提供元が公式に説明したモデルがある画像・動画のツールだ。FLUX、Kling、Seedance の説明は特定の版についてのもので、表に並ぶ最新のモデルがすべて拡散モデルだとは書かれていない。料金と日本語対応は、2026年10月10日から10月24日に確認した値である。
- Adobe Firefly:Adobe の解説ページは「Firefly is a diffusion model」と書いている。無料プランがあり、最も安い有料プランは Firefly Standard の月額1,580円(米国は$9.99)。画面は日本語に対応する。
- FLUX:Black Forest Labs は2024年8月1日の FLUX.1 の公開で、公開するすべての FLUX.1 が拡散トランスフォーマーのブロックを組み合わせた構造だと説明した。無料プランはなく、API の従量課金で FLUX 3 Image は1Kで1枚$0.048。
- Kling:Kuaishou の Kling Team は2025年12月の技術レポートで、Kling-Omni が拡散トランスフォーマーを使うと書いている。無料の Basic があり、最も安い有料プランは Standard の$8.8/月。画面は日本語に対応する。
- Seedance:ByteDance Seed は2025年6月の Seedance 1.0 の技術レポートで、Transformer を拡散の中心に使うと書いている。無料プランがあり、最も安い有料プランは Basic の¥2,380/月。
動画では、OpenAI が2024年2月15日の Sora の技術レポートで「Sora is a diffusion model」と書き、拡散トランスフォーマーだと説明した。ただし TRAIL の DB では、Sora の Web 版とアプリは2026年4月26日に、API は2026年9月24日に提供を終えたため、表には入れていない。TRAIL の表と年表では、2022年12月の DiT のあと、Sora、FLUX.1、Seedance 1.0、Kling-Omni の公式の説明がいずれも拡散トランスフォーマーを挙げている。
拡散モデルと GAN、自己回帰モデルの違い
Latent Diffusion の論文が画像を作るほかの方法と比べた記述をまとめると、次のとおりだ。
| 項目 | 拡散モデル | GAN(敵対的生成ネットワーク) | 自己回帰モデル |
|---|---|---|---|
| 作り方 | ノイズを段階的に取り除いて作る | 敵対的学習(adversarial learning)で学んだネットワークが作る | データを順に作る |
| 生成の速さ | 段階を順に計算するため、GAN より遅い | 高解像度の画像を効率よく作れる | 計算の重い構造で、順に作る |
| 学習 | GAN のような学習の不安定さがない | 最適化が難しい | 密度推定(データの分布の見積もり)に強い |
| 論文が挙げる弱点 | 学習と生成に大きな計算が要る | データ全体の分布をとらえにくい | 画素のままでは低い解像度にとどまる |
Latent Diffusion の論文は、画素のまま扱う強力な拡散モデルの例として、学習に V100 で150〜1,000 GPU 日、5万枚の生成に A100 1台で約5日かかった先行研究を挙げている。
仕事でどう関係するか
画像の一部だけを直したいとき
Latent Diffusion の論文によると、拡散モデルはインペインティング(画像の一部を消して描き直すこと)にもそのまま使える。論文の LDM はこの作業で当時の最高の成績を出した。TRAIL の年表では、FLUX は2024年11月1日にインペインティングとアウトペインティングを行う Fill を公開した。商品写真の背景だけを差し替えたい場面では、ツールにインペインティングの機能があるかが選ぶときの目安になる。
この写真の商品はそのまま残し、背景だけを白い大理石のテーブルと柔らかい自然光に描き直してください。商品の形、色、ロゴの文字は変えないでください。生成にかかる時間と費用を見積もるとき
拡散モデルは段階を順に計算するので、1回の生成に時間がかかる。ByteDance の技術レポートによると、Seedance 1.0 は5秒・1080p の動画を NVIDIA L20 で41.4秒で生成でき、多段の蒸留(大きなモデルの振る舞いを速いモデルに移す方法)などで推論を約10倍速くした。Seedance 1.0 の例のように、同じ拡散モデルでも速くする工夫で生成にかかる時間は大きく変わる。動画を大量に作る計画では、試しに数本作って時間と消費を測るとよい。
自社の商品や人物を覚えさせたいとき
DreamBooth の論文は、被写体の写真を数枚だけ与えて、文章から画像を作るモデルを調整する方法を示した。調整したモデルは元の写真にない場面、ポーズ、角度、光の当たり方でその被写体を描ける。これはファインチューニング(学習済みのモデルを追加のデータで調整すること)の一種だ。TRAIL の年表では、FLUX は2025年1月16日に1〜5枚の画像で FLUX.1 [pro] を調整できる API を公開し、2025年10月31日に提供を終えた。
生成した画像を社外に出すとき
DDPM の論文は、政治目的で著名人の偽の画像や動画を作ることに生成モデルが使われうる点と、学習データの偏りを映す点を挙げている。Latent Diffusion の論文も、生成モデルが学習データを再現してしまう場合があり、同意なく集めた個人の情報を含むときは大きな懸念になると書いている。TRAIL の年表では、Adobe は2023年3月21日のベータ公開で、Firefly の学習に Adobe Stock、オープンライセンス、パブリックドメインの素材を使うと説明した。社外に出す画像では、ツールごとの学習データと商用利用の条件を確かめる必要がある。
注意点と限界
- 生成は速くない。Latent Diffusion の論文は、計算を減らしたあとも、段階を順にたどる生成は GAN より遅いと書いている。
- 潜在空間で動かすモデルは、細かい精度が要る作業で限界が出る場合がある。同じ論文は、潜在空間に圧縮して戻す精度が、画素単位の正確さが要る作業では限界になりうると書いている。
- ツールの公式の記載は、特定のモデルについてのものだ。FLUX の記載は FLUX.1、Seedance は1.0、Kling は Kling-Omni についてのもので、表に並ぶ最新のモデルの構造まで書いたものではない。Black Forest Labs は FLUX.2 を潜在空間のフローマッチングの構造だと説明しており、FLUX.1 の発表ではフローマッチングを、拡散を特別な場合として含む学習の方法だとしている。
よくある質問
拡散モデルと生成AIの違いは何か
生成AIは文章、画像、動画などを作る AI 全体を指す。拡散モデルはその中の作り方の1つだ。上の表のツールには、拡散モデルを使うと提供元が公式に説明したモデルがある。
なぜ「拡散」と呼ぶのか
データにノイズを足して構造を壊していく前向きの過程を、論文が「拡散過程」と呼ぶからだ。2015年の Sohl-Dickstein らの論文は、この方法の着想を非平衡統計物理学から得たと書いている。
同じ指示でも毎回違う画像が出るのはなぜか
生成のたびに、でたらめなノイズから出発するからだ。DDPM の生成の手順では段階ごとにも新しいノイズを加える。そのため同じ文章でも、出てくる画像は毎回変わる。
Stable Diffusion や FLUX とはどう関係するか
FLUX を作る Black Forest Labs は、Stable Diffusion の開発者らが2024年に設立した会社だ(TRAIL の DB による)。同社は FLUX.1 の発表で、チームの実績として Latent Diffusion と、画像・動画生成の Stable Diffusion のモデルを挙げている。
動画も拡散モデルで作るのか
公式に書かれている例がある。OpenAI は Sora を、ByteDance は Seedance 1.0 を、Kuaishou は Kling-Omni を、拡散トランスフォーマーを使うモデルとして説明している。Sora は、動画と画像を圧縮した表現を時空間のパッチ(小さな区画)に分けて扱う。
関連する用語
出典
- Denoising Diffusion Probabilistic Models(arXiv:2006.11239)Jonathan Ho ほか
- Denoising Diffusion Probabilistic Models(HTML 版 v2)Jonathan Ho ほか
- High-Resolution Image Synthesis with Latent Diffusion Models(arXiv:2112.10752)Robin Rombach ほか
- High-Resolution Image Synthesis with Latent Diffusion Models(HTML 版 v2)Robin Rombach ほか
- Deep Unsupervised Learning using Nonequilibrium Thermodynamics(arXiv:1503.03585)Jascha Sohl-Dickstein ほか
- Photorealistic Text-to-Image Diffusion Models with Deep Language Understanding(arXiv:2205.11487)Chitwan Saharia ほか
- DreamBooth: Fine Tuning Text-to-Image Diffusion Models for Subject-Driven Generation(arXiv:2208.12242)Nataniel Ruiz ほか
- Scalable Diffusion Models with Transformers(arXiv:2212.09748)William Peebles、Saining Xie
- Video generation models as world simulatorsOpenAI
- Firefly vs Stable DiffusionAdobe
- Announcing Black Forest LabsBlack Forest Labs
- FLUX.2: Frontier Visual IntelligenceBlack Forest Labs
- Seedance 1.0: Exploring the Boundaries of Video Generation Models(HTML 版 v2)ByteDance Seed
- Kling-Omni Technical Report(HTML 版 v1)Kuaishou Technology(Kling Team)
- 公開
- 執筆
- TRAIL編集部(編集方針)