「ElevenLabs」の文字起こし「Scribe v3」公開 リアルタイム版は話者識別に対応
ElevenLabs は2026年11月10日、音声を文字にする Scribe v3 と v3 Live を公開した。発表では誤りが前のモデルより27%と43%少ない。前回のモデル更新から12日。料金は書かれていない。
この記事の要点
- ElevenLabs は2026年11月10日、音声を文字にするAIモデル Scribe v3 と Scribe v3 Live を公開した。
- 録音した音声は Scribe v3、通話のようなリアルタイムの音声は v3 Live が受け持つ。会議の記録や音声エージェントを作る会社に関係する。
- 両モデルは公開と同時に ElevenAPI で使える。v3 Live は ElevenAgents でも使える。料金は発表に書かれていない。
目次6
何が発表されたか
ElevenLabs は2026年11月10日、音声認識の Scribe v3 と v3 Live を公開した。音声認識は話した声を文字に起こす技術である。Scribe v3 は録音した音声向けのモデルだ。Scribe v3 Live はリアルタイムの音声向けで、遅延の小さい版にあたる。
性能の数字はすべて ElevenLabs の発表による。
- Scribe v3 は102言語で、前のモデルの Scribe v2 より単語の誤りが27%少ない。
- Scribe v3 Live は Scribe v2 Realtime より誤りが43%少ない。
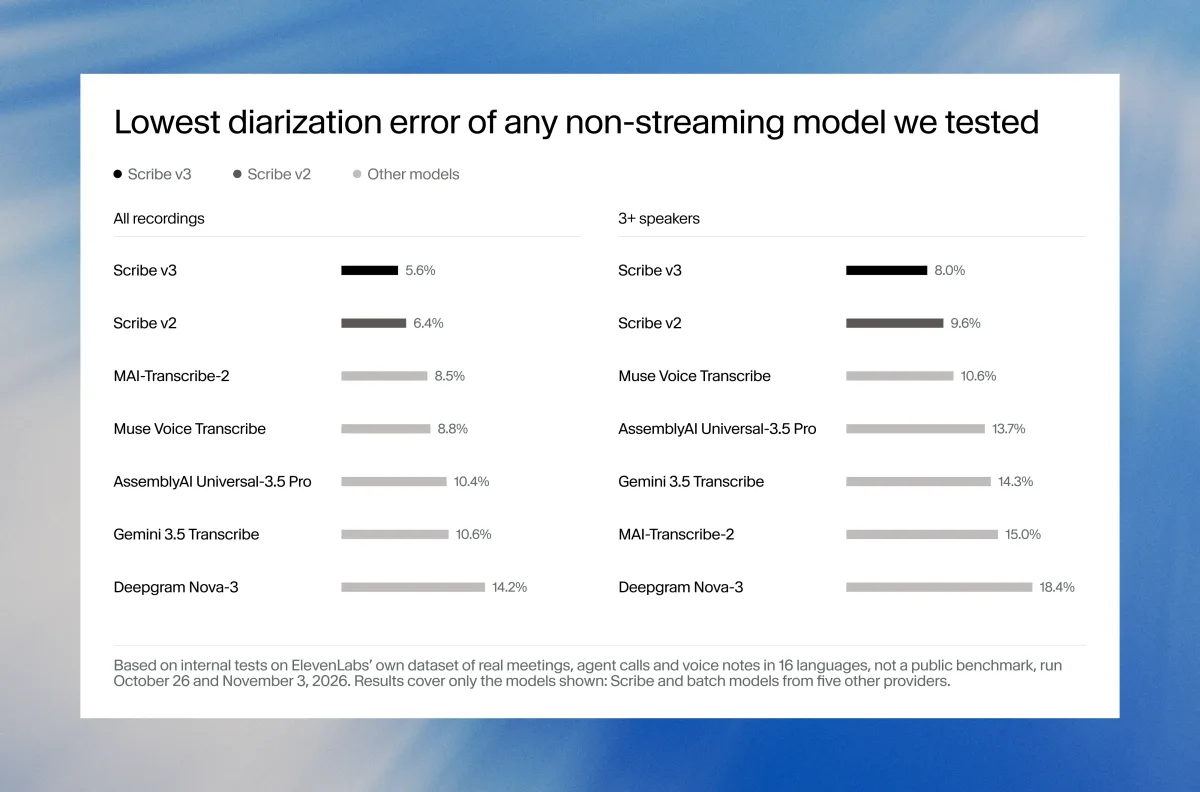
- Scribe v3 は3人以上が話す録音で、話者の識別の誤りが Scribe v2 より17%少ない。
話者の識別(diarization)は、誰が何を話したかを分けて記録する機能だ。リアルタイム向けの Scribe が話者の識別に対応するのは、v3 Live が初めてだ。
発表には話者の識別の誤りの割合を比べたグラフが載っている。Scribe v3、Scribe v2、ほかの会社のモデルが並ぶ。ElevenLabs が自社で集めた16言語の会議、エージェントとの通話、音声メモの録音を使い、2026年10月26日と11月3日に測った。グラフの注記は公開のベンチマークではないと断っている。
v3 Live は相手が話し終えたかどうかの判断も変えた。従来の仕組みは黙っている時間の長さで判断する。そのため、文の途中で間を置いた人の話を遮ることがあった。v3 Live は音声に加えて会話の流れも使う。番号を読み上げる途中で間を置いても、話を遮らないという。
Scribe v3 では出力の指定も増えた。
- 数字を「123」のような数字で返すか、言葉で返すかを選べる。
- 社名、略語、専門用語など、出てくると分かっている語を最大1,000語まで渡せる(Keyterm prompting)。
- 「日付はすべて YYYY-MM-DD で書く」のような書式の決まりを、ふつうの英語の文で指示できる(transcript edits)。
v3 Live には、文の途中で言語が切り替わる会話のための multilingual mode が加わった。一覧にしきれないほど多い語を登録しておく keyterm library も使える。
年表で見ると
TRAIL の年表で、ElevenLabs の前回のモデル更新は、2026年10月29日の効果音の生成モデル SFX v3 の公開だった。Scribe v3 はその12日後になる。基準日の2026年11月11日までの直近12件のモデル更新では、間隔の中央値は12日、最小は1日、最大は113日だ。
Scribe は2025年2月26日に公開された。その後、2025年11月11日に Scribe v2 Realtime、2026年1月9日に Scribe v2 が出ている。2026年9月22日には、医療の音声向けの Scribe v2 Medical が一般提供になった。10月28日には、Scribe の文字起こしで時刻を合わせるモデル Cue が発表された。
ElevenLabs の出来事は、2026年7月と8月はどちらも0件だった。9月は10件、10月は12件で、11月は11日までで8件ある。
TRAIL の年表では、今回の12日という間隔は、直近12件の中央値の12日と同じだ。出来事の数は7月と8月の0件から、9月と10月は10件以上に増えている。
同じカテゴリで比べると
音声AIの比較表に並ぶ Suno の直近のモデル更新は、2026年9月9日の v6 の公開だ。2026年11月11日から数えて63日前になる。Suno はその後、2026年10月1日に Speech(ベータ)を公開した。
誰が、いくらで使えるか
v3 Live は音声エージェントを作る ElevenAgents で公開の日から使える。両モデルは開発者向けの ElevenAPI でも使える。ElevenAPI で Scribe v2 を組み込んでいる場合は、モデル ID を scribe_v3 か scribe_v3_live に変えれば切り替わる。ElevenLabs のアプリでは、両モデルが既定のモデルになった。
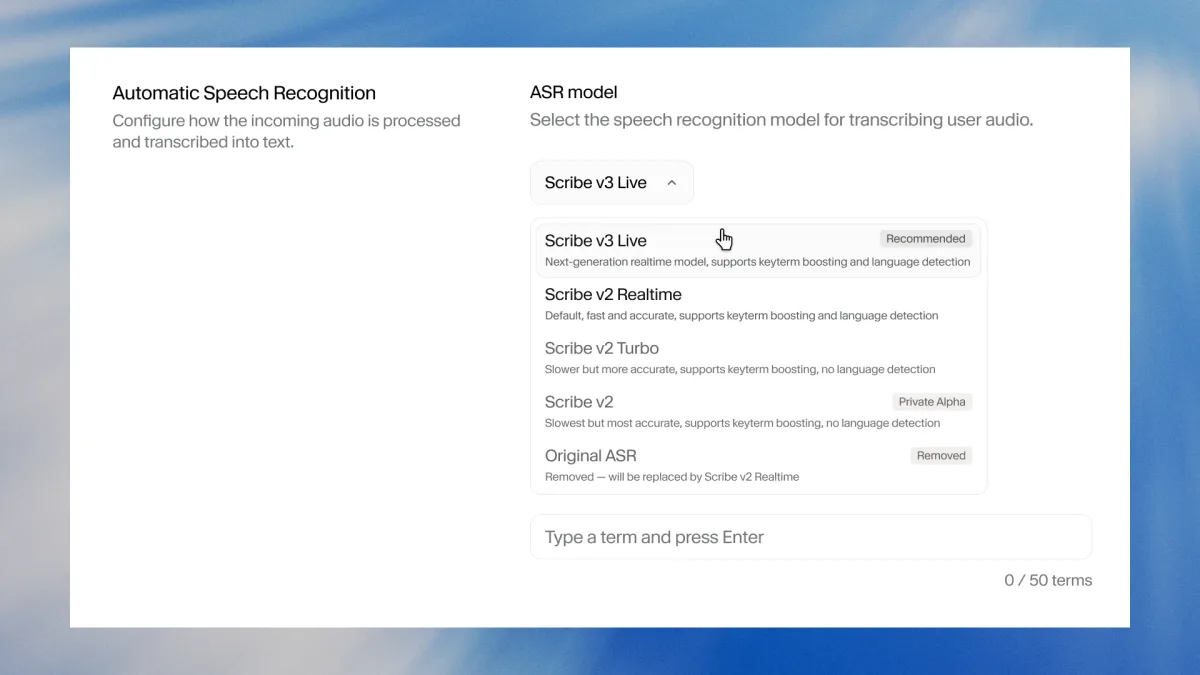
発表には音声認識の設定画面を写した画像も載っている。モデルの一覧から Scribe v3 Live を選んでいるところだ。
企業向けの条件も示された。両モデルは既定で米国で動く。データを置く場所に決まりがある企業顧客には、EU、インド、シンガポールの分離した環境も用意する。Zero Retention Mode を使うと、リクエストの処理が終わるとすぐに音声と文字が消される。
料金は発表に書かれていない。ElevenLabs の料金プランは Free(月$0)から Business(月$990)まであり、ほかに要問い合わせの Enterprise がある。TRAIL が2026年10月24日に確認した料金である。どのプランで Scribe v3 を使えるかは、発表からは分からない。
まだ分からないこと
- ElevenAPI で Scribe v3 と v3 Live を使うときの料金。
- 日本語の音声での精度。発表が言語ごとに挙げた数字に、日本語は出てこない。
- Scribe v2 と Scribe v2 Realtime をいつまで使えるか。
次に見るもの
ElevenLabs は話者の識別を測るために作った16言語の録音のデータセットを、近く公開するとしている。医療の会話に合わせた v3 Live の版を、ElevenAgents で出すとも書いている。
TRAIL の年表(重要度2以上)から作成。2026.11.10 まで。