MoEとは?意味・仕組みとMoEモデルの年表、関連論文(2026年10月時点)
MoE
Mixture of Experts / Mixture-of-Experts / 専門家の混合 / MoEモデル
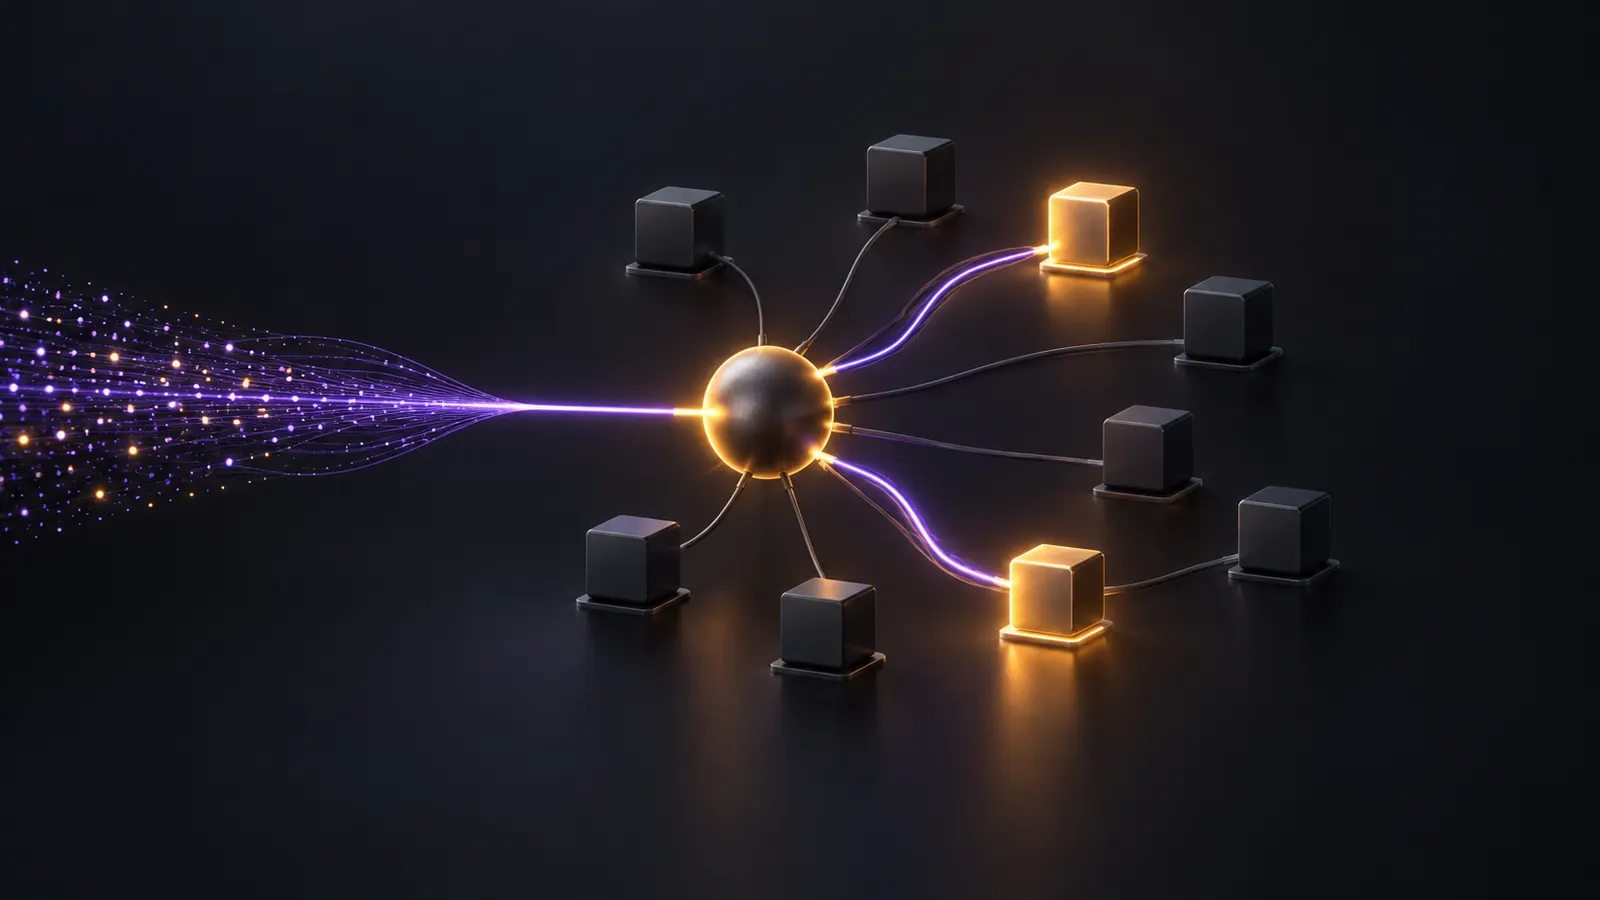
MoE(Mixture of Experts)とは、モデルの中に「専門家」と呼ぶ小さなネットワークを多数並べ、入力ごとにルーターが選んだ一部だけを動かすAIモデルの作り方のこと。
要するに
- ルーターが入力ごとに使う専門家を選び、選ばれた一部の専門家だけが計算する
- 仕様には、全体のパラメータ数と1トークンごとに動くパラメータ数の2つが並ぶ
- 1トークンで動く量が少なくても、全体の重みを置くための機械は必要になる
最終確認
公式に MoE と書かれたモデル
原論文と関連研究
- MoE原論文を読む 必要な部分だけを動かして容量を増やすOutrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer
- Switch Transformer 論文の解説:専門家を一つ選ぶ疎なモデルSwitch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity
- DeepSeek-V3 論文(技術報告)の解説:疎なMoEモデルの学習と配備DeepSeek-V3 Technical Report
目次8
ひとことで言うと
MoE(Mixture of Experts、専門家の混合)は、AI モデルの中に「専門家(エキスパート)」と呼ぶ小さなネットワークをたくさん並べ、入力ごとにその一部だけを動かす作り方だ。どの専門家を使うかは、ルーター(振り分け役のネットワーク)が入力を見て決める。モデル全体を大きくしながら、1回の計算で動かす量を抑えられる。
たとえば中国の DeepSeek が2024年12月に公開した DeepSeek-V3 は、全体で6,710億(671B)のパラメータ(学習で調整する数値)を持つ。それでも、1トークン(AI が文章を数える単位)を処理するときに動かすのは370億(37B)だと、同社の技術報告は書いている。
仕組み
もとになった論文は、2017年1月に Google Brain の Noam Shazeer らが発表した「Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer」だ。専門家を混ぜる考え方そのものは1991年の研究にさかのぼる。この論文は、MoE を深いモデルの部品として使う2013年の研究を土台に、入力ごとに一部の専門家だけを動かす層を示した。数式を使わずに流れを書くと、次のようになる。
- 専門家を並べる。原論文の MoE の層は最大で数千の専門家からなる。専門家はどれも同じ形の小さなネットワークで、それぞれ別のパラメータを持つ。
- ルーターが入力を見て、使う専門家を選ぶ。原論文はこれをゲーティングネットワークと呼び、点数の高い上位のいくつか(top-k)だけを残す。文章の位置ごとに、違う組み合わせを選べる。
- 選ばれた専門家だけが計算し、その結果をルーターの重みで足し合わせて出力にする。選ばれなかった専門家は計算しない。原論文の言語モデルの実験のうち、計算量をそろえて専門家の数だけを変えた比較では、どの MoE の層でも1つの入力で動く専門家は4つだった。
- ルーターもモデルのほかの部分と一緒に学習する。原論文によると、ルーターは同じ少数の専門家ばかりを選ぶ状態に陥りやすい。そこで原論文は専門家の使われ方をそろえるための追加の目標を学習に加えた。
原論文は MoE を、文を前から順に読む LSTM という型のネットワークの間に入れた。2021年1月の Switch Transformer の論文は、MoE を Transformer の中の全結合の層(FFN)に置き換える形で入れ、1つのトークンを1つの専門家だけに送るよう簡単にした。論文は、これでルーターの計算と通信の費用が減るとしている。2024年12月の DeepSeek-V3 は、MoE の各層に、毎回使う「共有の専門家」1つと、選んで使う専門家256個を置き、1トークンごとに256個のうち8個を動かす。
このため、MoE ではパラメータの数え方が2つある。全体のパラメータ数(total parameters)はモデルが持つ数値の総数で、専門家をすべて足した量になる。動くパラメータ数(active / activated parameters)は、1トークンを処理するときに実際に計算に使う量だ。
Switch Transformer の論文は、1つの入力あたりの計算量を変えずにパラメータの数を増やすことを、モデルを大きくする別の軸として扱った。公式の発表では、xAI は Grok-1 を、3,140億パラメータのうち1トークンで動く重みが25%の MoE と説明している。DeepSeek は DeepSeek-V4.1-Flash を全体552B の MoE とし、動くパラメータは入力で8B、出力で16B としている。
表で見る最新の状況
上の年表は TRAIL の DB から、公式の発表に MoE(Mixture-of-Experts)と書かれたモデルの出来事4件を古い順に並べたものだ。開発元は xAI、DeepSeek、Cursor の3つで、確認日はどれも2026年10月10日。発表に構造の記載がないモデルは入れていない。
- 2024年3月17日の「Grok-1 の重みを公開」:314B(3,140億)パラメータの MoE モデルの重みと構造を、Apache 2.0 ライセンスで公開した。
- 2024年12月26日の「DeepSeek-V3 を公開」:総パラメータ671B、活性化37B の MoE モデル。出力は毎秒60トークンで、V2 の約3倍とされた。モデルと論文はオープンソースで公開された。
- 2026年7月8日の「Grok 4.5 を公開」:Cursor が SpaceXAI と共同で学習した MoE のモデル。基本の料金は入力100万トークンあたり2ドル、出力6ドル(1万トークンあたり0.02ドルと0.06ドル)。
- 2026年9月10日の「DeepSeek-V4.1-Flash を公開」:総552B の MoE モデルで、画像も扱える。重みと論文も公開された。
TRAIL の年表では、MoE と公式に書かれたモデルは、重みを公開するモデルにも料金を払って製品の中で使うモデルにも出ている。Grok-1 と DeepSeek の2つのモデルは重みが公開され、Grok 4.5 は Cursor の中で使う有料のモデルだ。
その下の「原論文と関連研究」は、TRAIL の研究記事から MoE の論文3本を古い順に並べたものだ。
- MoE の原論文(2017年1月):最大1,370億パラメータの MoE を言語モデルと翻訳に使い、計算の効率をほとんど落とさずに容量を1,000倍以上に増やしたと報告した。
- Switch Transformer(2021年1月):専門家を1つだけ選ぶ形に簡単にし、同じ計算資源で T5 をもとにしたモデルより事前学習を最大7倍速くしたと報告した。1兆パラメータ規模のモデルも学習した。
- DeepSeek-V3(2024年12月):671B のうち37B を動かす MoE。学習全体に使った GPU の時間は H800 で278.8万時間と報告した。
MoE と密なモデル(dense モデル)の違い
Switch Transformer の論文は、MoE でない普通のモデルを、すべてのパラメータを毎回使う「密に動く(densely-activated)」モデルと呼んでいる。
| MoE(疎に動くモデル) | 密なモデル | |
|---|---|---|
| 入力ごとに動く部分 | ルーターが選んだ一部の専門家 | すべてのパラメータ |
| パラメータを増やしたときの計算量 | 1トークンあたりの計算量を一定に保てる | パラメータに合わせて計算量も増える |
| 仕様の書き方 | 全体と動く量の2つ(例:671B と37B) | 1つの数 |
| 論文が挙げる課題 | 仕組みの複雑さ、通信の費用、学習の不安定さ | 計算の費用がとても大きい |
原論文は、すべての入力でモデル全体を動かす普通のモデルでは、モデルと学習データを大きくするにつれて、学習の費用がおおよそ2乗で増えると書いている。MoE はこの費用の増え方を抑えるために、入力ごとにネットワークの一部だけを動かす「条件つきの計算」を実用にしたものだ。
仕事でどう関係するか
モデルの仕様の「総パラメータ」と「アクティブ」を読むとき
MoE のモデルの発表には、2つのパラメータ数が並ぶことがある。DeepSeek-V3 の「671B」は全体の量で、「37B」は1トークンごとに動く量だ。2つを取り違えると、別のモデルと大きさを比べるときに数字の意味がずれる。
重みが公開された MoE を社内で動かすか決めるとき
オープンウェイトの MoE は自分の環境で動かせるが、全体の重みを置く機械が要る。DeepSeek-V3 の技術報告は、効率よく推論するために勧める配備の単位が比較的大きく、小さなチームには負担になりうると書いている。報告によると、入力を読み込む段階の最小の配備は4ノード、32基の GPU だ。
次のモデルについて、全体のパラメータ数、1トークンで動くパラメータ数、公式が勧める GPU の台数を、公式のモデルカードか技術報告の URL つきで表にしてください。書かれていない項目は「記載なし」としてください。
(モデル名を3つ書く)
API の料金と速さを比べるとき
AI の API を選ぶときは、料金と出力の速さを比べる。DeepSeek は2024年12月の DeepSeek-V3 の発表で、出力が V2 の約3倍の毎秒60トークンになったとした。DeepSeek-V4.1-Flash の発表では、効率の高い構造によって API の料金を下げたと説明した。TRAIL の DB では、DeepSeek-V4.1-Flash の API 料金はピーク時間帯に入力100万トークンあたり0.3ドル、出力1.2ドルで、それ以外の時間帯は半額だ(2026年10月16日確認)。
注意点と限界
- 動くパラメータが少なくても、小さな機械で動くとは限らない。Switch Transformer の論文は、専門家の重みを複数の機器に分けて置いている。DeepSeek-V3 の技術報告も、配備の単位の大きさを限界に挙げている。
- 専門家への振り分けが偏ると、効率が落ちる。DeepSeek-V3 の技術報告は、負荷の偏りがルーティングの崩壊を招くと書き、偏りを防ぐ追加の目標を大きくしすぎると性能が下がるとも書いている。
- Switch Transformer の論文では、専門家ごとに受け取れるトークンの数に上限があり、あふれたトークンはその層で処理されない。
- 学習の安定も課題として残る。Switch Transformer の論文は、最大級のモデルの学習の安定を課題に挙げ、論文の工夫は Switch-XXL では足りず未解決だと書いている。
- パラメータの総数だけでは性能を比べられない。同じ論文では、1.6兆パラメータの Switch-C が質問応答の SQuAD で87.7、パラメータが少なく1トークンあたりの計算が約10倍の Switch-XXL が89.6だった。
よくある質問
MoE とは何か、簡単に言うと
モデルの中に「専門家」と呼ぶ小さなネットワークを多数並べ、入力ごとに一部だけを動かす AI モデルの作り方だ。どれを動かすかはルーターが選ぶ。
「専門家」とは人間の専門家のことか
違う。ここでの専門家はモデルの中にある同じ形の小さなネットワークのことだ。どの専門家が何を受け持つかは学習の中で決まり、原論文では専門家が文法や意味に応じて分かれる傾向が見られた。
総パラメータとアクティブパラメータの違いは何か
総パラメータはモデルが持つ数値のすべてで、アクティブパラメータは1トークンを処理するときに実際に使う分だ。DeepSeek-V3 では、総パラメータが671B、アクティブが37B だ。MoE でない密なモデルでは、2つは同じになる。
どのモデルが MoE を使っているか
TRAIL の年表では、Grok-1、DeepSeek-V3、Cursor の Grok 4.5、DeepSeek-V4.1-Flash が、公式の発表で MoE と書かれている。公式の発表に構造が書かれていないモデルは、年表に入れていない。
MoE と Mixture-of-Agents(MoA)は同じか
同じではない。MoE は1つのモデルの中の層の作り方だ。TRAIL の年表では、Genspark が2024年12月18日に発表した Mixture-of-Agents は、複数のエージェントを組み合わせるシステムとして紹介されている。
MoE と Transformer は別のものか
MoE はモデルの中に入れる部品の名前だ。原論文は LSTM の層の間に入れたが、Switch Transformer や DeepSeek-V3 は Transformer の中の全結合の層を MoE に置き換えている。どちらも Transformer の一部を MoE にした形だ。
関連する用語
- Transformer:Switch Transformer や DeepSeek-V3 は、この構造の一部を MoE にした
- LLM(大規模言語モデル):DeepSeek-V3 は MoE の言語モデル
- オープンウェイト:Grok-1 や DeepSeek の MoE モデルは重みが公開された
- AI の API:DeepSeek-V4.1-Flash や Grok 4.5 は API でも使える
- 研究記事:MoE の原論文、Switch Transformer、DeepSeek-V3
- モデル:DeepSeek-V4.1-Flash、Grok 4.5
- ツール:DeepSeek、Grok、Cursor
出典
- Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer(arXiv:1701.06538)arXiv
- Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer(arXiv:1701.06538v1、HTML 版)Noam Shazeer ほか
- Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity(arXiv:2101.03961)arXiv
- Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity(arXiv:2101.03961v3、HTML 版)William Fedus ほか
- DeepSeek-V3 Technical Report(arXiv:2412.19437)arXiv
- DeepSeek-V3 Technical Report(arXiv:2412.19437v2、HTML 版)DeepSeek-AI ほか
- Introducing DeepSeek-V3DeepSeek
- DeepSeek-V4.1-Flash: Smarter, Faster, More EfficientDeepSeek
- Open Release of Grok-1xAI
- Introducing Grok 4.5Cursor
- 公開
- 執筆
- TRAIL編集部(編集方針)